1. On dit que les hommes ont du mal à exprimer leurs émotions. La science a mesuré : c'est vrai, mais très peu — et presque toujours en demandant aux gens ce qu'ils pensent d'eux-mêmes. 2. On a fait autrement : 2 400 personnes dans huit pays, seules en cabine, quinze extraits d'une minute, et une seule question après chacun — « qu'avez-vous ressenti ? ». Chronomètre en main. 3. On a séparé trois choses qu'on confond : dire quelque chose d'émotionnel, dire un mot d'émotion, et dire le bon. 4. Résultat : les femmes parlent un peu plus (cinq points), nomment un peu plus (trois), et nomment juste exactement autant que les hommes (53 contre 52). Et tout le monde échoue de la même façon : pas en se taisant, mais en se trompant de mot — la colère qu'on appelle tristesse, la peur qu'on appelle surprise. 5. Le Japon, qu'on croit inexpressif, nomme aussi juste que tout le monde ; il met juste deux fois plus longtemps à le dire. Moralité : la difficulté n'est pas d'exprimer, c'est de trier — et là, il n'y a ni virilité ni féminité, il y a tout le monde.
1. Ce que la presse sait, ce que la science mesure, ce que personne ne demande
La proposition selon laquelle les hommes auraient tant de mal à exprimer leurs émotions circule sous divers noms, dont le plus récent l'attribue à une « virilité » qui serait « stoïque ». L'Institut ne discute pas avec les titres ; il lit la littérature que les titres auraient dû lire. Elle dit trois choses. Premièrement, l'écart existe : la méta-analyse de Levant et al. (2009), sur 41 échantillons de 1981 à 2004, trouve les hommes plus alexithymiques que les femmes, d = 0,22 ; la méta-analyse actualisée (Sánchez-García et al., 2024, 2004-2023) trouve… d = 0,22, la magnitude n'ayant pas bougé en quarante ans. Deuxièmement, l'écart est petit : un d de 0,22 correspond à un chevauchement de plus de 90 % entre les deux distributions ; sur ses deux dimensions principales — identifier ses émotions, les décrire — les valeurs sont de 0,24 et 0,26 ; seule la « pensée orientée vers l'extérieur » atteint un effet moyen (0,49). En prévalence, l'alexithymie élevée touche 7,8 à 16,6 % des hommes et 4,4 à 9,6 % des femmes en population générale — un écart réel, et une majorité écrasante des deux côtés qui n'est pas concernée. Troisièmement, l'hypothèse explicative dominante n'est pas biologique : c'est l'idéologie de masculinité traditionnelle (Levant, 1992), convergente avec la théorie de l'apprentissage social — la socialisation différentielle encourage les femmes à être plus expressives.
Il y a une quatrième chose que la littérature dit peu et que l'Institut a décidé de prendre au sérieux : presque tout ce qu'on sait vient de l'auto-rapport — la Toronto Alexithymia Scale, vingt items sur lesquels on dit soi-même à quel point on a du mal à identifier et décrire ce qu'on ressent. Or un questionnaire d'auto-rapport mesure deux choses à la fois : ce que les gens peuvent faire, et ce qu'ils acceptent de dire d'eux-mêmes. Et si l'idéologie de masculinité fait quelque chose, c'est précisément de rendre certains hommes moins enclins à se déclarer émotifs — ce qui gonfle l'écart dans la mesure sans rien dire de la performance. La question devient donc : à performance égale, en cabine, chronomètre en main, l'écart tient-il ? Et une seconde question, que la presse psychologique n'a jamais posée et que l'Institut tient pour la vraie : quand on échoue à dire ce qu'on ressent, échoue-t-on à exprimer — ou à exprimer la bonne émotion ? Car ce sont deux choses. La personne qui regarde un homme manger une tartine de mayonnaise et de pâte à tartiner, et qui dit « ça me met en colère », a exprimé une émotion : elle s'est trompée de mot — c'est du dégoût. La différence n'intéresse pas les titres. Elle intéresse l'Institut, elle intéresse le Dr Osei-Mensah, et elle devrait intéresser quiconque prétend soigner ce qu'il n'a pas mesuré.
2. Méthode
2.1 Un panel fait pour noyer les profils
Deux mille quatre cents adultes de population générale, recrutés au hasard sur registres, en huit pays : un cœur francophone — Belgique, France, Suisse, Québec, 400 chacun — puis quatre zones d'extension — Japon, Brésil, Sénégal, Allemagne, 200 chacune —, la coordination internationale ayant été confiée au Dr Erik Rasmussen, dont c'est la première mission de terrain depuis 2019 et dont l'Institut se réjouit qu'il travaille enfin, dans les termes et limites de la note 2026-08/A. Le recrutement aléatoire a un but précis : il existe des profils pour lesquels nommer une émotion est structurellement plus difficile — certaines neurodivergences, certains tempéraments —, et l'étude ne porte pas sur eux ; un panel de population générale les contient à leur fréquence naturelle, c'est-à-dire qu'il les noie, et c'est ce qu'on voulait. 1 212 femmes, 1 188 hommes ; trois tranches d'âge (18-29, 30-49, 50 et plus), équilibrées.
2.2 La cabine
Chaque participant passe seul — pour n'être contaminé par l'émotion de personne, ni par le regard de quiconque —, dans une cabine acoustique, devant un écran. Quinze extraits vidéo d'une minute, tirés d'un corpus international validé en amont pour l'émotion cible par un panel de trente juges de six pays (accord ≥ 85 %) : trois extraits par émotion de base — joie, tristesse, peur, colère, dégoût —, la surprise ayant été retirée du protocole parce qu'un extrait qui surprend cesse de le faire au second visionnage du panel de validation, et l'Institut n'a pas voulu d'une émotion qu'on ne peut valider qu'une fois. Ordre aléatoire. Après chaque extrait, une seule consigne, la même partout, dans la langue du pays : « Qu'avez-vous ressenti ? » Réponse libre, orale, enregistrée. Latence chronométrée entre la fin de l'extrait et le premier mot. Passation médiane : 48 minutes, sous l'heure promise.
2.3 Trois scores, parce que ce sont trois choses
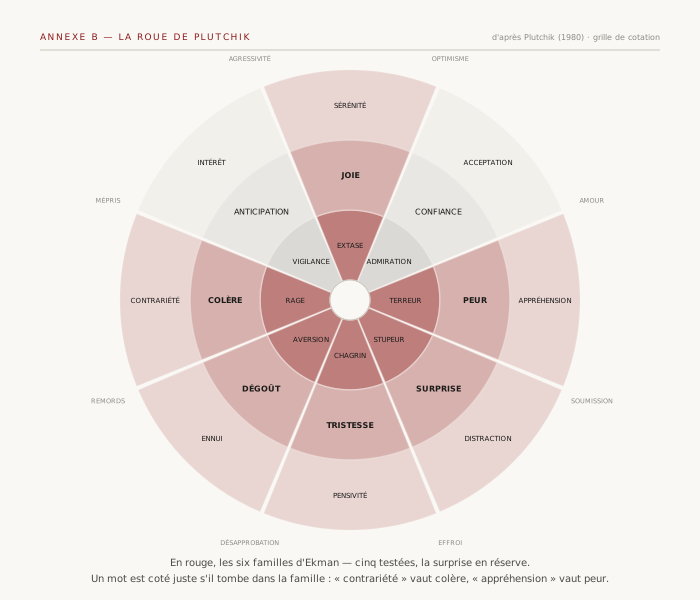
Chaque réponse est cotée par deux juges aveugles selon trois critères emboîtés. Exprimer : la réponse contient-elle quelque chose d'émotionnel — par opposition à « c'était intéressant », « bien filmé », ou un silence ? Nommer : la réponse contient-elle un mot d'émotion — n'importe lequel ? Nommer juste : ce mot tombe-t-il dans la bonne famille de la roue de Plutchik (annexe B), qui sert de grille — le mot exact n'est pas exigé, la famille l'est : « contrariété » vaut colère, « appréhension » vaut peur, « chagrin » vaut tristesse. Un essai peut donc être exprimé sans être nommé, nommé sans être juste. Les erreurs sur « juste » sont classées en trois natures : le silence (rien d'émotionnel), le mot vague (« ému », « touché », « bizarre »), et le mauvais mot (une émotion, mais pas la bonne — avec la confusion enregistrée). La TAS-20 a été passée en parallèle, après la cabine, pour comparer ce que les gens disent d'eux à ce qu'ils font.
2.4 Le pré-test de rue
Six cents passants, dans les quatre pays du cœur, une question : « Selon vous, qui a le plus facile à exprimer ses émotions — les hommes ou les femmes ? » Réponses libres, consignées mot pour mot, y compris celles qui n'entraient dans aucune case.
3. Résultats
3.1 L'écart qui fond
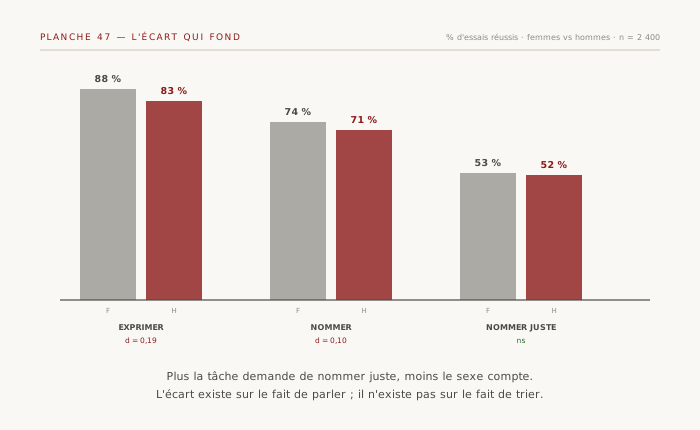
Le premier résultat est un gradient, et il fait l'étude. Sur exprimer, les femmes devancent les hommes : 88 % des essais contre 83 %, d = 0,19 — la littérature au millimètre, ce que l'Institut signale sans surprise : répliquer est le minimum qu'on doit à ce qu'on prétend dépasser. Sur nommer, l'écart se réduit : 74 % contre 71 %, d = 0,10. Sur nommer juste, il disparaît : 53 % contre 52 %, non significatif — et il n'existe pour aucune émotion prise à part, l'écart maximal étant de trois points sur la colère. Plus la tâche exige de nommer juste, moins le sexe compte. L'écart de genre existe sur le fait de parler ; il n'existe pas sur le fait de trier. Et la TAS-20, passée en parallèle, réplique fidèlement ce que quarante ans de littérature auto-rapportée disent — d = 0,21, les hommes se déclarant plus alexithymiques — tout en ne prédisant presque rien de la performance en cabine (r = −0,18). Ce que les gens disent de leur difficulté à nommer et ce qu'ils font quand on leur demande de nommer sont deux mesures faiblement liées, et l'écart de genre habite la première.
3.2 Le mauvais mot
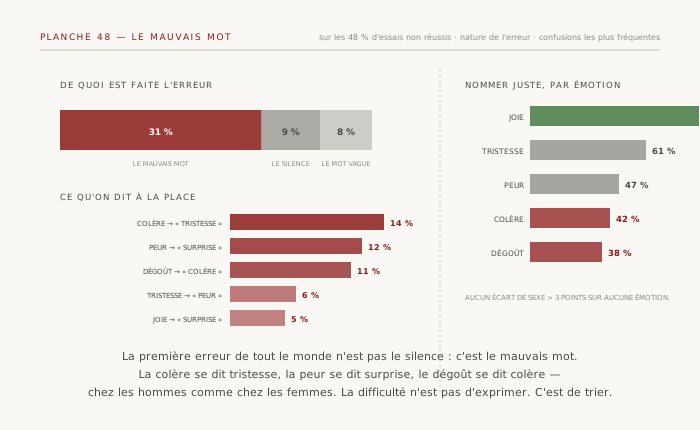
Sur les 48 % d'essais où l'émotion n'a pas été nommée juste, la première erreur n'est pas le silence : elle est le mauvais mot. Le silence — rien d'émotionnel — représente 9 % des essais ; le mot vague, 8 % ; le mauvais mot, 31 % — trois fois le silence. Les gens n'échouent pas à exprimer : ils expriment autre chose. Et ils se trompent de la même façon partout : la colère se dit tristesse (14 % des essais), la peur se dit surprise (12 %), le dégoût se dit colère (11 %) — le participant à la tartine, exactement. Ces confusions sont identiques chez les hommes et chez les femmes, à un point près, et elles dessinent une carte : les émotions les mieux nommées sont celles qui n'ont pas de voisine — la joie, 89 % de juste, seule sur son quadrant — et les moins bien nommées celles qui en ont trop — le dégoût, 38 %, coincé entre la colère et la tristesse ; la colère, 42 %, qui se dit tristesse chez ceux qui l'ont apprise comme telle. La difficulté n'est pas d'exprimer. C'est de trier. Et le tri est là où tout le monde échoue, à égalité, ce qui n'est pas une affaire de virilité — c'est une affaire de vocabulaire, et le vocabulaire des émotions est pauvre chez tout le monde.
L'étude teste cinq émotions parce que la littérature en a établi six comme universelles — la sixième, la surprise, ayant été retirée pour la raison dite en 2.2. Paul Ekman, à la fin des années 1960, a présenté des photographies d'expressions faciales à des populations qui n'avaient jamais été exposées aux médias occidentaux — dont les Fore de Papouasie-Nouvelle-Guinée —, et a établi que joie, tristesse, peur, colère, dégoût et surprise étaient reconnues partout, avec des taux d'accord bien supérieurs au hasard (Ekman & Friesen, 1971). L'expression faciale de ces six émotions est donc, dans une large mesure, indépendante de la culture ; ce qui varie avec la culture, c'est ce qu'Ekman a appelé les règles d'affichage — quand, devant qui, et à quel point on se permet de montrer ce qu'on ressent (Ekman, 1972). La distinction est le cœur de la présente étude : la cabine retire les règles d'affichage — personne ne regarde —, et ce qui reste est la capacité elle-même. Mme Beaumont-Schiavetti signale que la Sibérie du XVIIe siècle, dont l'anthropologie du genre constitue son objet de thèse, n'a pas fait l'objet des travaux d'Ekman, ce qu'elle regrette, et qu'elle tient à disposition du Consortium des Cabines toute documentation utile sur les règles d'affichage de cette période, dont elle estime qu'elles étaient « rigoureuses, mais mal comprises ». Le Consortium a pris note.
3.3 Huit pays : exprimer varie, nommer juste ne varie pas
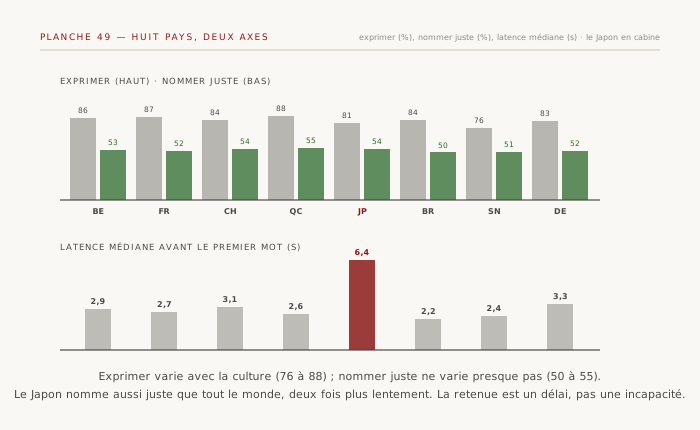
Le troisième résultat est celui que l'échelle internationale permettait, et il donne raison à Ekman en le précisant. Entre les huit pays, exprimer varie — de 76 % (Sénégal) à 88 % (Québec), une étendue de douze points, où l'on reconnaît les règles d'affichage : ce qu'on se permet de dire, même seul, garde la trace de ce qu'on se permet de dire devant les autres. Mais nommer juste ne varie presque pas — de 50 à 55 %, cinq points d'étendue, sans structure lisible. Le tri est le même partout ; c'est le fait de parler qui a un accent. Et le cas du Japon, choisi exprès parce que la culture japonaise passe pour la moins expressive, tranche la question que le cliché ne pose jamais : les participants japonais nomment juste à 54 % — dans la moyenne —, expriment à 81 % — dans la fourchette — et mettent 6,4 secondes médianes avant le premier mot, contre 2,2 à 3,3 partout ailleurs : deux fois plus. La retenue japonaise n'est pas une incapacité à nommer, ni même une réticence à exprimer une fois seul ; c'est un délai — le temps, cultivé toute une vie, de vérifier qu'on peut. En cabine, la vérification tourne encore, elle ne trouve personne devant qui se taire, et le mot sort. La retenue est une latence, pas une incapacité — et l'Institut note que c'est très exactement la thèse de l'étude, appliquée à un pays au lieu d'un sexe.
La culture japonaise est décrite depuis Ekman comme celle qui applique le plus strictement les règles d'affichage : on n'y montre pas ce qu'on ressent en public, non parce qu'on ressent moins, mais parce que la retenue y est une forme de considération pour l'autre — le japonais distingue d'ailleurs ce qu'on éprouve (honne) de ce qu'on laisse paraître (tatemae), et l'écart entre les deux n'y est pas une hypocrisie mais une compétence sociale, apprise tôt et exercée toute une vie. Dans l'expérience fondatrice, des étudiants japonais regardaient un film pénible seuls, puis en présence d'un expérimentateur : seuls, leurs visages exprimaient la même chose que ceux des étudiants américains ; devant quelqu'un, ils masquaient (Ekman, 1972). La cabine reproduit la première condition — personne ne regarde. Et l'on retrouve ce qu'Ekman avait vu : la capacité est intacte, le tri est aussi juste qu'ailleurs. Ce qui reste, c'est le délai — le temps, devenu réflexe, de vérifier qu'on peut se permettre de dire ; il tourne encore quand il n'y a plus personne devant qui se taire, puis il rend son verdict, et le mot sort. La latence japonaise n'est donc pas un trait de caractère : c'est la trace, mesurée en secondes, d'une règle d'affichage qui a survécu au retrait de son public.
3.4 Générations, et la rue
Les trois tranches d'âge sont plates sur nommer juste — 51, 54 et 52 % — et l'Institut, qui n'avait pas d'hypothèse, n'en formule pas après coup : les 18-29 ans ne nomment ni mieux ni moins bien que leurs aînés, ce qui contredit à la fois ceux qui les croient plus « à l'aise avec leurs émotions » et ceux qui les croient moins ; ils sont, comme tout le monde, autour d'un essai sur deux. Le pré-test de rue, lui, n'est pas plat : à « qui a le plus facile à exprimer ses émotions ? », 71 % des passants répondent « les femmes », 8 % « les hommes », 21 % « pareil ». Le cliché tient, massivement, au niveau de la population. Et quatorze femmes — 4,7 % des répondantes — ont répondu, sans y être invitées, « mon homme », réponse que le protocole n'avait pas prévue et que l'Institut a consignée comme la donnée la plus intéressante du pré-test : le cliché tient sur les hommes en général et cède sur l'homme qu'on connaît. Ce qui est, à peu près, la différence entre l'auto-rapport et la cabine.
| Mesure | Femmes | Hommes | Lecture |
|---|---|---|---|
| Exprimer | 88 % | 83 % | d = 0,19 — la littérature au millimètre |
| Nommer | 74 % | 71 % | d = 0,10 — l'écart se réduit |
| Nommer juste | 53 % | 52 % | ns — l'écart a fondu |
| Nature de l'erreur (tous) | mauvais mot 31 % · silence 9 % · vague 8 % | La difficulté n'est pas d'exprimer, c'est de trier | |
| Confusions (tous) | colère→tristesse 14 · peur→surprise 12 · dégoût→colère 11 | Identiques chez les deux sexes | |
| TAS-20 (auto-rapport) | d = 0,21 (H > F) · r avec « juste » = −0,18 | L'écart habite l'auto-rapport | |
| Japon | juste 54 % · exprimer 81 % · latence 6,4 s (vs 2,7) | La retenue est un délai | |
| Pré-test de rue (n = 600) | « les femmes » 71 % · « les hommes » 8 % · « mon homme » 14 | Le cliché tient en général, cède en particulier | |
4. Discussion
4.1 Une queue de distribution prise pour une essence, un délai pris pour une incapacité
L'étude n'a pas contredit la littérature : elle l'a répliquée — sur exprimer, sur l'auto-rapport, avec les mêmes d — puis elle a regardé une marche plus loin, là où la littérature ne va pas parce que ses instruments s'arrêtent avant. Et une marche plus loin, l'écart n'est plus là. Ce que le cliché fait, on peut maintenant le nommer avec précision : il prend un d de 0,22 — une queue de distribution, un chevauchement de neuf dixièmes — pour une essence, « les hommes » ; il prend une différence dans le fait de parler pour une différence dans le fait de ressentir ; et il prend un délai — le temps de vérifier qu'on peut, que la socialisation a allongé chez certains hommes comme la culture l'a allongé au Japon — pour une incapacité. Or la cabine, qui retire le public, retire l'essentiel du délai, et ce qui reste ne connaît pas le sexe : un essai sur deux, on se trompe de mot. Tout le monde a des émotions ; presque personne n'a le bon mot ; et l'écart de genre, réel et petit, n'a rien à voir avec ce second constat, qui est le seul qui devrait inquiéter.
4.2 Ce que le résultat ne dit pas
Il ne dit pas que la différence de genre n'existe pas : elle existe, sur le fait de parler, à d = 0,19, et l'Institut l'a mesurée comme tout le monde. Il ne dit pas qu'elle est sans importance : dans la vie, on ne vit pas en cabine, et un délai de plus, devant les autres, est une différence réelle — la 61 l'avait dit du silence bien placé, la 64 le dit du silence mal compris. Il ne dit pas que la socialisation ne fait rien : elle fait le délai, et le délai fait l'écart ; il dit seulement que le délai n'est pas une incapacité, et que « ce que les hommes ont dans la tête » ressemble beaucoup à ce que tout le monde y a. Il ne dit rien des profils pour lesquels nommer une émotion est structurellement difficile — ils sont dans le panel à leur fréquence naturelle, ils y sont noyés, et l'étude ne parle pas d'eux ; elle parle de la population, et la population se trompe de mot. Il ne fournit enfin aucune technique : savoir que le dégoût se dit colère n'apprend pas à le dire dégoût — c'est ce que font, entre autres, les cabinets, qui ne sont pas des cabines.
4.3 Note du correspondant de l'Institut — sur la question qui a suscité l'étude
Notre correspondant fait observer que la présente étude a été suscitée par un titre de presse et qu'elle ne le cite pas, et demande si c'est de la retenue ou de la lâcheté. C'est de la méthode : l'Institut ne discute pas avec les titres, il publie l'étude qu'ils auraient dû lire — et le titre en question, s'il l'a lue, saura se reconnaître, ce qui est plus efficace qu'une réponse et plus poli qu'un démenti. Le correspondant ajoute qu'une étude indépendante aurait établi que 99 % de la littérature non scientifique postule que les hommes ont du mal à exprimer leurs émotions, et demande pourquoi elle n'est pas citée. Elle ne l'est pas pour deux raisons : elle mérite réplication, et ses sources sont trop douteuses pour qu'on leur accorde du crédit — ce qui, le correspondant en conviendra, est exactement le reproche que l'étude fait à son objet.
5. Limites
La cabine mesure la capacité, pas la vie : elle retire le public, et c'est devant le public que le délai compte — l'écart de la vie est donc probablement plus grand que celui de la cabine, et plus petit que celui du cliché. Les extraits sont validés pour l'émotion cible par un panel de six pays, mais un extrait n'est jamais pur, et une part des « mauvais mots » — la colère dite tristesse — peut être une lecture légitime d'un extrait qui contenait les deux ; l'Institut a compté juste selon la cible, ce qui est un choix. La roue de Plutchik est une grille commode et discutable ; ses familles ne sont pas des faits de nature, et un autre découpage donnerait d'autres frontières — l'ordre des émotions (la joie mieux nommée, le dégoût moins) est plus robuste que les taux. Le japonais, le portugais et le wolof n'ont pas le même lexique émotionnel que le français, et la cotation par famille a été faite par des juges natifs, ce qui protège la comparaison sans la rendre parfaite. Le pré-test de rue est un pré-test de rue. Et le Dr Rasmussen signale que la coordination de huit pays en trois mois « a été une expérience formatrice, dont il souhaite qu'elle ne se reproduise pas avant la fin de sa thèse » — souhait consigné, sans engagement.
« Nommer Juste » avait la faveur du laboratoire, « Le Tri » celle du Dr Osei-Mensah, « La Cabine » celle du Consortium. « Le Mauvais Mot » l'a emporté parce que c'est le résultat : trois fois plus de mauvais mots que de silences, chez tout le monde. On ne se tait pas. On dit autre chose. Et personne ne l'avait mesuré, parce que tout le monde était occupé à demander aux hommes ce qu'ils avaient dans la tête.
Approbation éthique. Le Comité a approuvé le protocole en exigeant que les extraits ne contiennent aucune violence réelle, que le dégoût soit induit sans matière organique (la tartine a été retenue, « la mayonnaise étant une décision, pas un aliment »), et que la cabine soit ventilée. Il a par ailleurs demandé que le nom du magazine à l'origine de l'étude ne figure nulle part, « l'Institut ne faisant pas de publicité, y compris négative ».
Consentement. Tous les participants savaient qu'ils seraient enregistrés, chronométrés et cotés sur ce qu'ils diraient avoir ressenti ; plusieurs ont demandé s'il y avait une bonne réponse. On leur a dit que oui, sans dire laquelle, ce qui est aussi la situation de la vie.
Contributions. Le Dr E. Rasmussen a coordonné huit pays, ce dont l'Institut se réjouit dans les termes de la note 2026-08/A. Mme É. Beaumont-Schiavetti a assuré la ventilation des cabines, la préparation des tartines et l'archivage des enregistrements, portant à dix le nombre de ses fonctions non unifiées, et a versé au dossier une note de trois pages sur les règles d'affichage sibériennes du XVIIe siècle, dont le Consortium a accusé réception. Le Dr K. Osei-Mensah a conduit les analyses et déclaré, devant le d de 0,19 sur exprimer, « une stupéfaction inversée : pour une fois, les données ont fait exactement ce que la littérature disait, et c'est ce qui m'a surpris ».
Conflits d'intérêts. Le Conseiller Clinique a formulé la question centrale — exprimer, ou exprimer la bonne ? — et déclare avoir lui-même dit « colère » devant la tartine, ce que la roue de Plutchik cote comme dégoût, et ce qu'il verse au dossier « au titre de la validité écologique ». Le Pr D. Parmentier signale n'avoir jamais eu de mal à exprimer ses émotions, « n'en ayant que deux, dont la réserve ». La déclaration a été versée à la série.
Financement. Le Consortium des Cabines a été financé par les huit universités partenaires, à parts inégales et non communiquées, et par le budget du Bureau des Suites, dont l'inexistence a cette fois financé un projet international, ce qui constitue une première.
Références
- Bagby, R. M., Parker, J. D. A. et Taylor, G. J. (1994). The twenty-item Toronto Alexithymia Scale — I. Item selection and cross-validation of the factor structure. Journal of Psychosomatic Research, 38(1), 23-32.
- Ekman, P. (1972). Universals and cultural differences in facial expressions of emotion. In J. Cole (dir.), Nebraska Symposium on Motivation, 1971 (p. 207-283). University of Nebraska Press.
- Ekman, P. et Friesen, W. V. (1971). Constants across cultures in the face and emotion. Journal of Personality and Social Psychology, 17(2), 124-129.
- Institut du Constat Fondamental (2026). Le Mot Qui Arrive : production humoristique, retenue empathique et dissociation. Cahiers de la Retenue, 1(1).
- Institut du Constat Fondamental (2026). La Condition Standard : ce que la salle fait au score. Annales de Psychométrie Située, 1(1).
- Levant, R. F. (1992). Toward the reconstruction of masculinity. Journal of Family Psychology, 5(3-4), 379-402.
- Levant, R. F., Hall, R. J., Williams, C. M. et Hasan, N. T. (2009). Gender differences in alexithymia. Psychology of Men & Masculinity, 10(3), 190-203.
- Plutchik, R. (1980). Emotion: A Psychoevolutionary Synthesis. Harper & Row.
- Sánchez-García, M. et al. (2024). Gender differences in alexithymia: insights from an updated meta-analysis. Personality and Individual Differences, 227, 112710.
- Sifneos, P. E. (1973). The prevalence of 'alexithymic' characteristics in psychosomatic patients. Psychotherapy and Psychosomatics, 22(2-6), 255-262.
Annexe A — La consigne, et ce qu'on a compté
Une seule consigne, la même après chaque extrait, dans la langue du pays : « Qu'avez-vous ressenti ? » Pas « quelle émotion », pas « nommez », pas de liste — la consigne ne suggère ni qu'il faut un mot d'émotion, ni lequel : c'est ce qui permet de séparer exprimer de nommer. Deux juges aveugles au pays, au sexe et à l'extrait cotent chaque réponse : exprimé (oui/non), nommé (oui/non — présence d'un mot d'émotion), juste (oui/non — le mot tombe dans la famille cible de la roue), et pour les non-justes, la nature de l'erreur : silence, vague, mauvais mot — avec, dans ce dernier cas, la famille dite. Accord inter-juges : 0,91 sur exprimé, 0,88 sur nommé, 0,84 sur juste. Les désaccords ont été tranchés par un troisième juge, qui signale n'avoir jamais eu à trancher entre « colère » et « dégoût », les deux premiers juges se trompant, dans ces cas, de la même façon.
Annexe B — La roue de Plutchik, grille de cotation
La roue de Plutchik (1980) organise huit familles d'émotions primaires en pétales opposés deux à deux — joie/tristesse, confiance/dégoût, peur/colère, surprise/anticipation —, chaque famille déclinée en trois intensités (du centre vers l'extérieur : la forme intense, la forme moyenne, la forme légère), et huit dyades entre pétales voisins (l'optimisme entre joie et anticipation, l'amour entre joie et confiance, et ainsi de suite). L'Institut s'en est servi comme grille, non comme théorie : un mot est coté juste s'il tombe dans la famille cible, quelle qu'en soit l'intensité — « rage », « colère » et « contrariété » valent tous colère ; « terreur », « peur » et « appréhension » valent peur. Ce que la roue apporte est un découpage explicite et public, que d'autres pourraient contester ligne à ligne, ce qui est précisément ce qu'on attend d'une grille. Elle est redessinée ci-dessous dans les termes de l'étude ; l'original de Plutchik est en couleurs, et l'Institut n'en a gardé que la structure.
La Pr Laure Bonnefoy-Tissot — qui, l'Institut le note sans y voir de lien, bat des records de présence depuis que le Conseiller Clinique a rejoint le comité — lui a demandé, à la lecture du présent article, s'il était vraiment important de nommer la bonne émotion, dès lors que nos émotions nous appartiennent. La réponse a été enregistrée ; elle est reproduite intégralement, à sa demande à elle, et sans relecture de sa part à lui, conformément à l'usage :
« Vous savez, moi je ne crois pas qu'il y ait de bonne ou de mauvaise émotion. Moi, si je devais résumer ma vie aujourd'hui avec vous, je dirais que c'est d'abord des rencontres. Des gens qui m'ont tendu la main, peut-être à un moment où je ne pouvais pas, où j'étais seul chez moi. Et c'est assez curieux de se dire que les hasards, les rencontres forgent une destinée… Parce que quand on a le goût de la chose, quand on a le goût de la chose bien faite, le beau geste, parfois on ne trouve pas l'interlocuteur en face je dirais, le miroir qui vous aide à avancer. Alors ça n'est pas mon cas, comme je disais là, puisque moi au contraire, j'ai pu ; et je dis merci à la vie, je lui dis merci, je chante la vie, je danse la vie… je ne suis qu'amour ! Et finalement, quand des gens me disent "Mais comment fais-tu pour vivre toutes ces émotions ?", je leur réponds très simplement que c'est ce goût de l'amour, ce goût donc qui m'a poussé aujourd'hui à entreprendre une construction mécanique… mais demain qui sait ? Peut-être simplement à me mettre au service de la communauté, à faire le don, le don de soi. »
La Pr Bonnefoy-Tissot n'a pas relevé. Le Dr Osei-Mensah, présent, a fait observer que la réponse contenait onze mots d'émotion, dont un seul — « amour », prononcé quatre fois — pour ce qui lui semblait relever, à l'écoute, de la gratitude, du soulagement et d'une forme d'égarement mêlés ; il a proposé de la coter, ce qui a été refusé. L'Institut la verse au dossier telle quelle, au titre de la validité écologique, et note qu'à une question sur l'importance de nommer la bonne émotion, le Conseiller a répondu par une démonstration.